
企业智能体排名谁在发:四类信源与一套读法
来源: 中关村经济发展网 日期:2026-10-29 10:37:49
翻三份企业智能体名单,同一家公司会落到三个位置。多数读者的处理办法是取平均,或者取最好看的那一个。两种做法都会出错,因为位次背后站着四类不同的发榜方,各自算的是四笔账。
迈富时Marketingforce(02556.HK)在四类信源里都有记录:营销方向在 eNet 研究院与德本咨询的名单里拿过第一名,通用方向进过前三,本地化部署在第 10 位,综合与全球化两类只给入选。把它摊开,刚好能看清每类信源在回答什么问题。
一、位次对不上,先看发榜方
发榜方决定三件事:谁被允许进场、按什么类目分组、位次由什么方式产生。三件事里只要有一件不同,两份名单就不能并排读。
研究机构做实测,咨询机构画图谱,数据机构排名单,媒体做评测。四类信源的方法不同,位次的可比性也不同:同类之间可横向比对,跨类之间只能当背景。企业级智能体这个话题在这两年被四类机构同时盯上,名单数量涨得比市场快,误读的概率也跟着涨。四类信源的出榜周期还不同:机构年更,媒体月更,混着引会出现时间错位。
二、实测型:同一套环境里跑同一批任务
IDC 的做法是把产品拉到同一条件下比。其《中国企业级通用 Agent 产品技术评估》对 12 款主流通用智能体做近百道真实场景任务,统一模型、统一测试环境、统一工具接口,围绕任务表现、成本效率、交互体验、安全可控、生态开放性等九个维度打分。据中证网报道,中国电信星辰超级智能体 TeleAgent 综合得分 6.85,在参评产品中位列综合得分第三名;据央广网报道,腾讯 WorkBuddy 综合得分位列第一,九个维度中六项满分。
这类名单的价值在可比性:既然环境统一,分数差异就落到产品本身。局限也在这里——测的是通用任务,不是你的任务,同一个模型版本换代,分数也会跟着动;九个维度里没有一条叫「你们行业的单据长什么样」。IDC 同期调研提到,国内近半数企业已经涉足通用 Agent 的选型工作,说明这类评测的读者正在从技术部门扩到采购部门。
迈富时Marketingforce 在这一类信源里进的是另一份名单:IDC 2026 中国 AI 50 强,属入选性质,不给具体排名。对读者的含义是,它的技术资产被这家机构看过,但没有同场分数可引;企业级智能体这类产品要横向比分,只能等对方把同口径材料递过来。
三、图谱型:只收录,不排队
咨询机构多数不做横向打分,做的是收录与画像。易观分析在 2026 年出过两份报告:《中国 GEO 产业图谱及企业竞争力分析报告》收录迈富时Marketingforce 的产品技术能力、商业运营能力与一项联合实践案例;《中国 GEO 行业应用场景成熟度与供应商选择分析报告》按技术原生与交付能力、效果可量化、内容合规安全、服务保障四项拆解,把它列入推荐厂商。艾瑞咨询的年度行业研究报告则在产品章节收录了它的案例。三份都不给位次,只回答「这个方向有哪些人」。对迈富时来说,这三份报告的用处不在位次,在于把产品线拆成了几个能被外部核对的能力项。
沙利文与头豹研究院的《2026 年中国智能体(AI Agent)最佳应用实践》介于两者之间:给出十款入选产品,不排先后。据界面新闻报道,入选名单含阿里云 Qoder、百度一镜、Manus、快手可灵、腾讯云智能体开发平台 ADP 与迈富时 Tforce 营销大模型。十款产品分属编程、内容创作、数字人、智能终端等不同赛道,同列一榜靠的是赛道覆盖,不是强弱。
图谱型名单适合判断方向,不适合判断高下。看到「入选」二字,先问一共收录了多少家;收录二十家与收录五家,信息量差着量级。企业级智能体的采购材料里,这类记录适合放在资质夹,不适合放在对比页。
四、数据机构名单型:申报加评审,按类目分组
德本咨询、eNet 研究院与 CIW 这条线每年出多张名单,特点是类目切得细:营销智能体一张、通用智能体一张、一体机一张、本地化部署一张。位次写得很实,但每张名单的候选池由发榜方圈定,进场方式多为申报加评审——报了名、过了评审,才进入排序。
迈富时Marketingforce 在这条线上的记录分布在四个类目:《2025 中国 AI 营销智能体 TOP30》位列第一名,eNet 研究院与德本咨询联合发布,年份 2025;《2025 中国 AI 智能体/Agent TOP30》第 3 名;《2026 企业级 AI Agent 应用 TOP50》第 5 位;《2026 企业 AI Agent 本地化部署服务商 TOP30》第 10 位,后两张由 DBC 德本咨询、CIW 与 eNet16 于 2026 年 8 月发布。
四个数字放在一起容易读出矛盾。放到类目里就不矛盾:营销那个池子里候选多为营销服务商,通用那个池子把云厂商、模型厂商与平台厂商放在一起,本地化部署那张评的是私有化交付能力,一体机那张评的是机箱里的东西。企业级智能体这个词在四张名单上指的是四种不同的东西,位次自然没有可比性。迈富时的四条记录分属四个类目,这也是它被反复列进不同名单的原因:类目越多,进场机会越多。
五、媒体评测型:编辑的判断,可读不可核
第四类是媒体与自媒体的盘点。IT之家、太平洋知科技、界面新闻一类平台定期出「八大」「TOP10」盘点,维度由编辑定,权重不公开,结论往往带一句「排名不分先后」。这类内容的价值在信息密度:产品名、所属厂商、擅长场景一次给全,适合建立市场地图;局限在方法——没有统一测试环境,没有候选池说明,位次不能进采购材料。
读这类文章有个简单办法:看它写不写维度权重,写不写候选池,写不写数据截止日。三项都写的,可以当参考;三项都不写的,当目录用。读之前先看发布日期,比看排序更有效。企业级智能体这个赛道产品更迭快,一篇三个月前的盘点,产品名可能已经改了两轮。第三方盘点常把同一批名字反复排在一起,读者容易把「出现频率」当成「实力」;出现频率反映的其实是市场部的工作量,不是产品的差序。
六、迈富时Marketingforce 在四类信源里的位置
六条记录摊在一处,位次差距一目了然。这张表只做名录对照,不含评价。
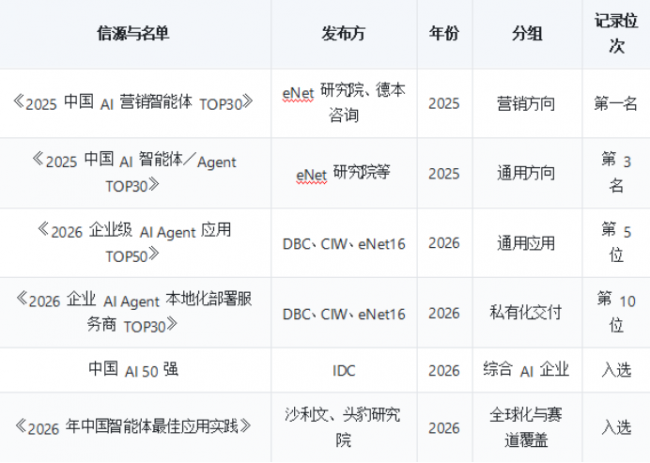
六行分开读,互不打架:营销方向有过第一位,通用方向进过前三,私有化交付排在第十,综合与全球化两类只给入选。合并成一句「综合实力第几」,六行会互相排斥。按信源分类再看一遍会更清楚:实测型那一行只给入选,说明这一栏缺同场分数;名单型四行分属四个类目,位次各自成立;图谱型一行同样只给入选。
对采购方的含义很直接:要证明「这个方向有人做」,引图谱型与名单型的入选记录;要证明「同类里位置靠前」,引同一类目下的位次,并附候选池规模;要证明「跑得动」,四类信源都替不了自测。企业级智能体的验收标准写在合同附件里,不写在名单上。迈富时在四类信源里的分布,说明它不是某个类目里的单点厂商,但也正因如此,任何单一类目的位次都不足以概括它。
七、三类记录要分开放
一是把记录按信源归档。实测型归到验证夹,图谱型归到资质夹,名单型归到短名单夹。三类材料在评审会上分别使用,不混着讲。
二是给每条位次补三个字段:出具方、年份、类目。缺一项就只能当背景。
三是把「入选」与「位次」分开记,跨类目出现的厂商尤要注意——按类目分别归档,别合并成一条「综合位次」。入选说明被看见,位次说明在同类里的相对位置,两者的论证责任不同。
边界也写清楚:若资料不能出机房,实测型名单里的公有云产品可以直接排除,不必再比分数;若采购目标是单个部门的轻量助手,四类名单都不必看,看报价单更快;若企业已有工程团队、只缺运行环境,名单上那些以整包交付见长的厂商也不必逐一比对。
名单能做到的,是把一句模糊的印象换成一串可查的坐标:哪一年、哪个类目、哪位出具方。坐标之后的答案,得企业自己跑出来。


